Отчёт об индексировании в Google Search Console легко принять за список ошибок. Там может быть несколько тысяч непроиндексированных URL, таблица с причинами и довольно неприятный график. Первая реакция обычно понятная: надо добиться, чтобы все страницы стали зелёными.
Но индексироваться должны не все URL сайта. Например, страница с корректным 301 редиректом, служебная страница с noindex и дубль с правильно указанным canonical не должны попадать в поиск. В этих случаях Search Console не сообщает об ошибке, а объясняет, почему Google выбрал другой URL или вообще не стал добавлять страницу в индекс.
Поэтому я обычно начинаю не с количества исключённых страниц, а с вопроса: какие именно URL попали в каждую группу и должны ли они участвовать в поиске.
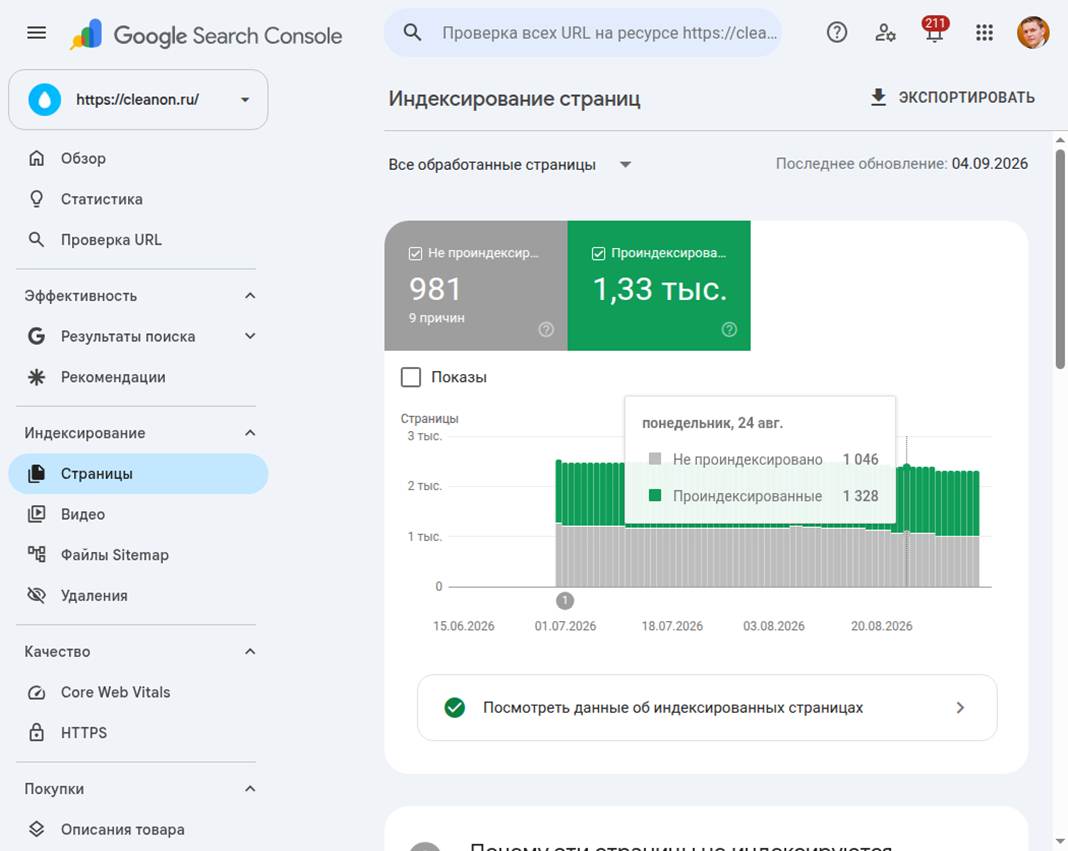
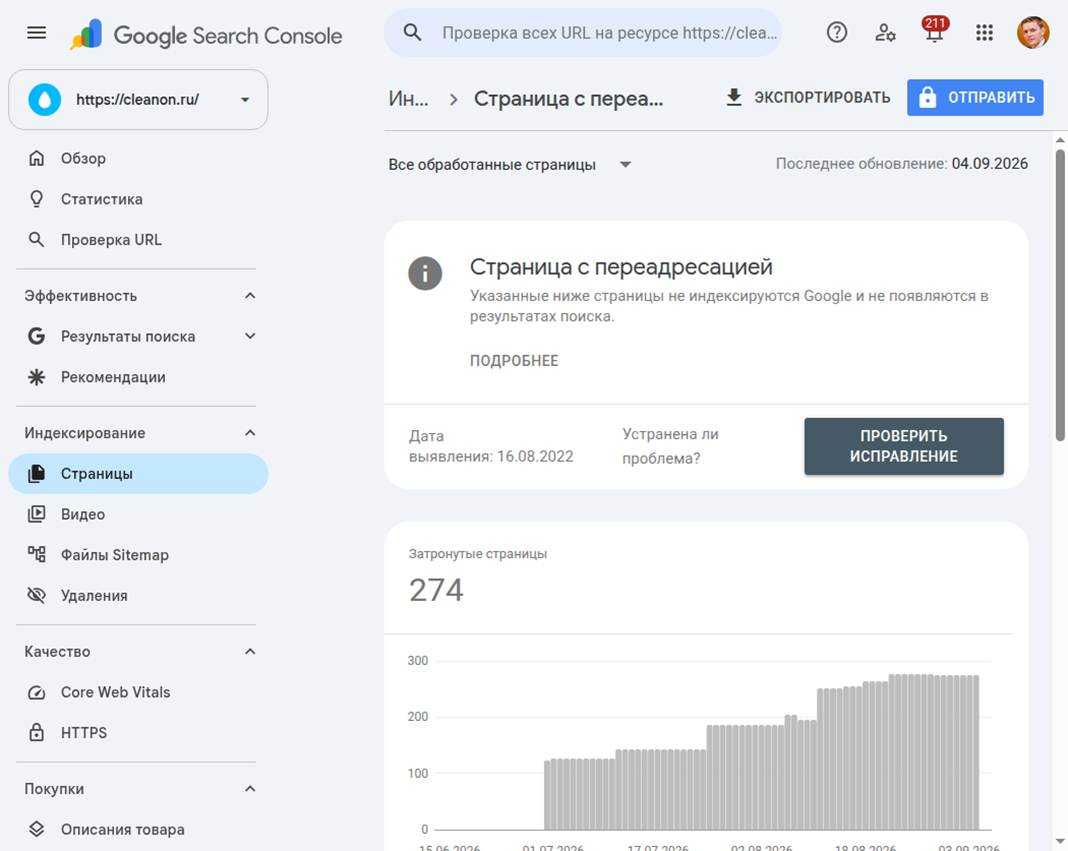
Например, на этом сайте на момент съёмки было 981 исключённая и 1,33 тыс. проиндексированных страниц. Но уже первые две группы объясняют большую часть серой зоны: 338 вариантов с canonical и 274 URL с переадресацией. По одной общей цифре нельзя понять, есть ли проблема.
В этой статье разберу все основные причины из отчёта, покажу реальные примеры из Google Search Console и объясню, где действительно требуется исправление, а где лучше ничего не трогать.
Как открыть отчёт и с чего начать проверку
Откройте нужный ресурс в Google Search Console и перейдите в раздел «Индексирование» → «Страницы». В верхней части отчёта Google показывает количество проиндексированных и непроиндексированных URL. Ниже находится таблица «Почему эти страницы не индексируются».
Само соотношение зелёных и серых URL почти ничего не говорит о качестве сайта. У интернет-магазина могут быть тысячи фильтров и параметров, которые не должны индексироваться. На небольшом сайте услуг большая доля исключённых страниц, наоборот, может указывать на дубли, старые адреса или технические ошибки.
Я бы проверял отчёт в таком порядке:
- Посмотреть, проиндексированы ли основные страницы: главная, услуги, категории, товары или статьи, которые должны получать поисковый трафик.
- Открыть каждую причину и изучить примеры URL. Search Console показывает не более 1000 примеров, поэтому это выборка, а не полный список.
- Разделить URL по шаблонам. Одна причина может объединять нормальные служебные адреса и важные страницы с ошибкой.
- Проверить несколько URL через инструмент проверки URL, а затем сделать проверку опубликованной страницы.
- После исправления проверить весь шаблон, а не один пример, и только потом запускать «Проверить исправление».
Полезно также отфильтровать отчёт по файлу Sitemap. Так проще понять, есть ли среди исключённых URL страницы, которые вы сами передали Google как предназначенные для индексирования.
Какие статусы обычно не требуют исправления
К нормальным исключениям чаще всего относятся:
- страница с переадресацией, если редирект настроен намеренно и ведёт сразу на рабочий URL;
- вариант страницы с тегом canonical, если Google проиндексировал нужную каноническую версию;
- страница с noindex, если вы сознательно закрыли её от поиска;
- 404 или 410 для удалённого URL, у которого нет подходящей замены;
- дубль, если Google выбрал правильный канонический адрес.
Но даже нормальный статус стоит проверить по примерам. Один случайный URL услуги среди сотен технических адресов может оказаться важнее всей общей цифры.
Доступ к URL заблокирован в файле robots.txt
Что означает статус
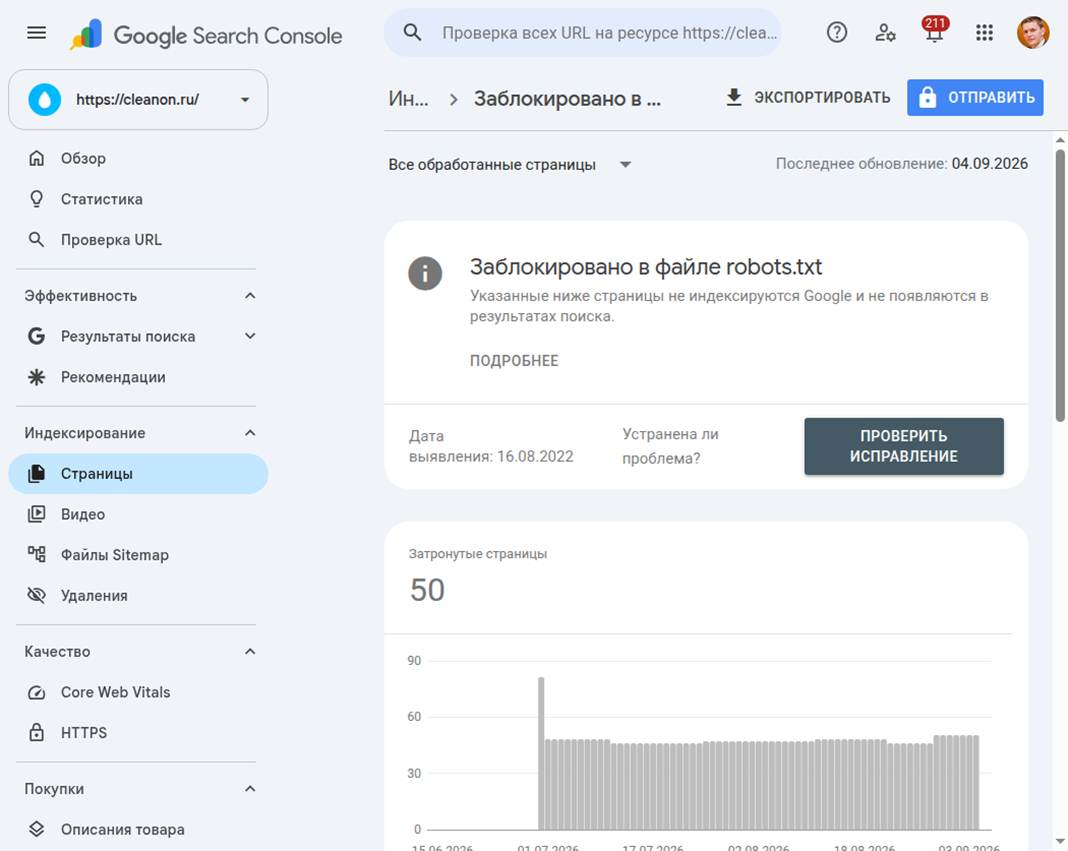
Google знает об URL, но правило Disallow в файле robots.txt запрещает его сканировать. Иногда адрес всё равно может появиться в индексе по внешним или внутренним ссылкам, но Google не сможет прочитать содержимое страницы.
Когда это нормально
Блокировка может быть намеренной для технических разделов, результатов внутреннего поиска, некоторых параметров и бесконечных комбинаций фильтров. Важно, чтобы среди таких URL не было страниц, которые должны получать трафик.
Что проверить
- какое именно правило закрывает URL;
- есть ли адрес в XML Sitemap;
- стоят ли на него внутренние ссылки;
- получает ли URL внешние ссылки;
- не закрыты ли нужные для рендеринга CSS и JavaScript;
- возвращает ли сам файл robots.txt код 200.
Как исправить
Если страница должна индексироваться, уберите или сузьте правило Disallow. Если страницу нужно удалить из индекса, одного robots.txt недостаточно: Google должен иметь возможность открыть URL и увидеть директиву noindex. Сначала разрешите сканирование, затем добавьте noindex и дождитесь повторного обхода.
Страница с переадресацией
Что означает статус
URL возвращает код 3xx и переводит пользователя и робота на другой адрес. Исходная страница не индексируется, а конечная может попасть в индекс.
Когда это нормально
После переезда на HTTPS, смены структуры, объединения страниц или настройки единого варианта со слешем этот статус ожидаем. Исправлять сам факт редиректа не нужно.
Что проверить
- ведёт ли редирект на действительно подходящую страницу;
- нет ли цепочки из нескольких переходов;
- не ссылается ли сайт внутри на старые URL;
- отсутствуют ли редиректные адреса в Sitemap;
- не перенаправляется ли важная страница по ошибке.
Как исправить
Замените внутренние ссылки и URL в Sitemap на конечные адреса с кодом 200. Цепочки лучше сократить до одного перехода. Если редирект появился случайно, исправьте правило на сервере или настройку CMS.
Вариант страницы с тегом canonical
Что означает статус
Страница указывает с помощью rel=»canonical» на другой URL, и Google согласился с этим выбором. В индекс попала каноническая версия, а текущий адрес исключён.
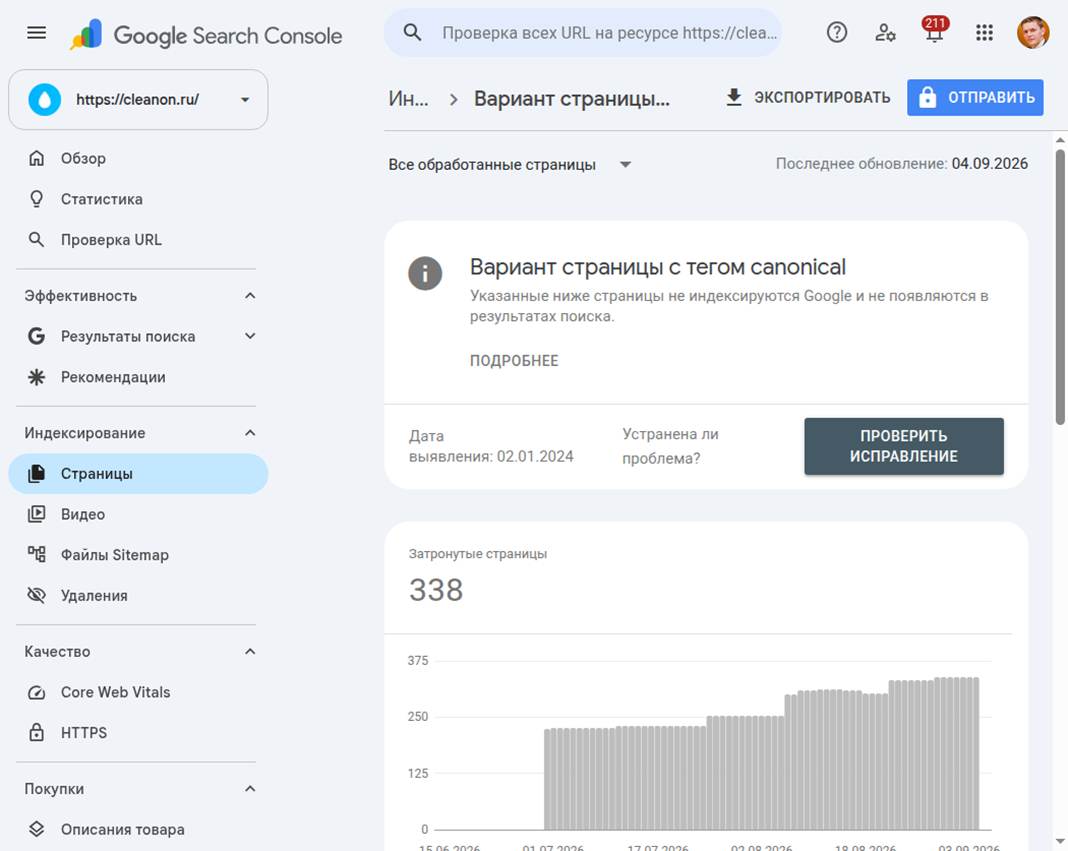
Когда это нормально
Например, параметрическая версия товара может ссылаться на чистый URL без параметров. Такой адрес не обязан индексироваться отдельно.
Что проверить
- соответствует ли canonical содержанию страницы;
- возвращает ли канонический URL код 200;
- разрешена ли его индексация;
- указан ли именно канонический URL в Sitemap и внутренних ссылках;
- не создаёт ли сайт лишние альтернативные URL без функциональной необходимости.
Как исправить
Если Google выбрал нужный адрес, ничего исправлять не надо. Если уникальная страница по ошибке ссылается на другой URL, поставьте самоссылочный canonical и согласуйте с ним Sitemap, внутренние ссылки, редиректы и hreflang.
Не найдено (404)
Что означает статус
При запросе URL сервер вернул код 404. Google мог найти адрес по старой ссылке, из прошлой версии сайта, из Sitemap или из внешнего источника.
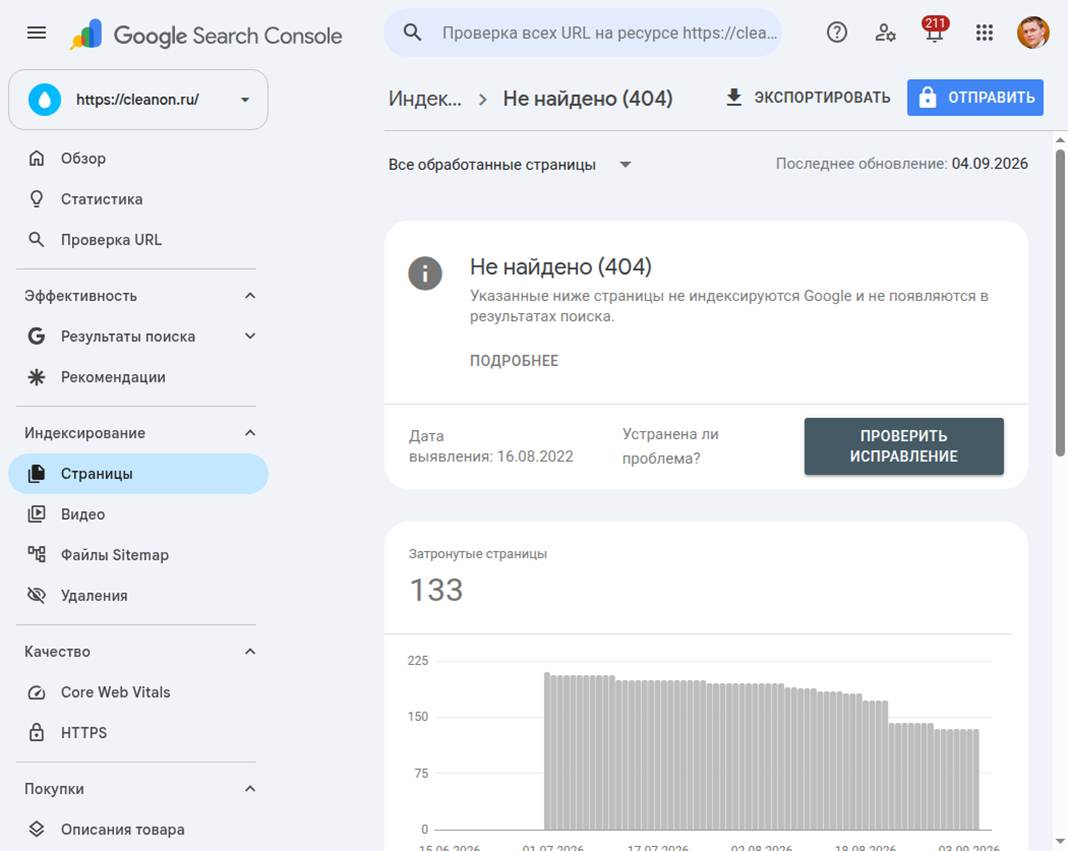
Когда это нормально
Если страница удалена навсегда и у неё нет равноценной замены, корректный ответ 404 или 410 является нормальным. Google ещё некоторое время будет обращаться к адресу, затем частота обхода снизится.
Что проверить
- есть ли URL во внутренних ссылках или Sitemap;
- существовала ли страница раньше;
- есть ли у неё трафик или внешние ссылки;
- появился ли подходящий новый адрес;
- не возникли ли 404 после массового изменения структуры.
Как исправить
Верните страницу, если она удалена случайно. Если она переехала, настройте 301 на ближайший по смыслу новый URL. Если замены нет, оставьте 404 или 410 и удалите адрес из Sitemap и внутренних ссылок. Массово перенаправлять все удалённые страницы на главную не стоит: Google часто воспринимает такие ответы как ложные 404.
Страница содержит директиву noindex
Что означает статус
Google смог просканировать страницу и обнаружил директиву noindex в метатеге robots или HTTP-заголовке X-Robots-Tag.
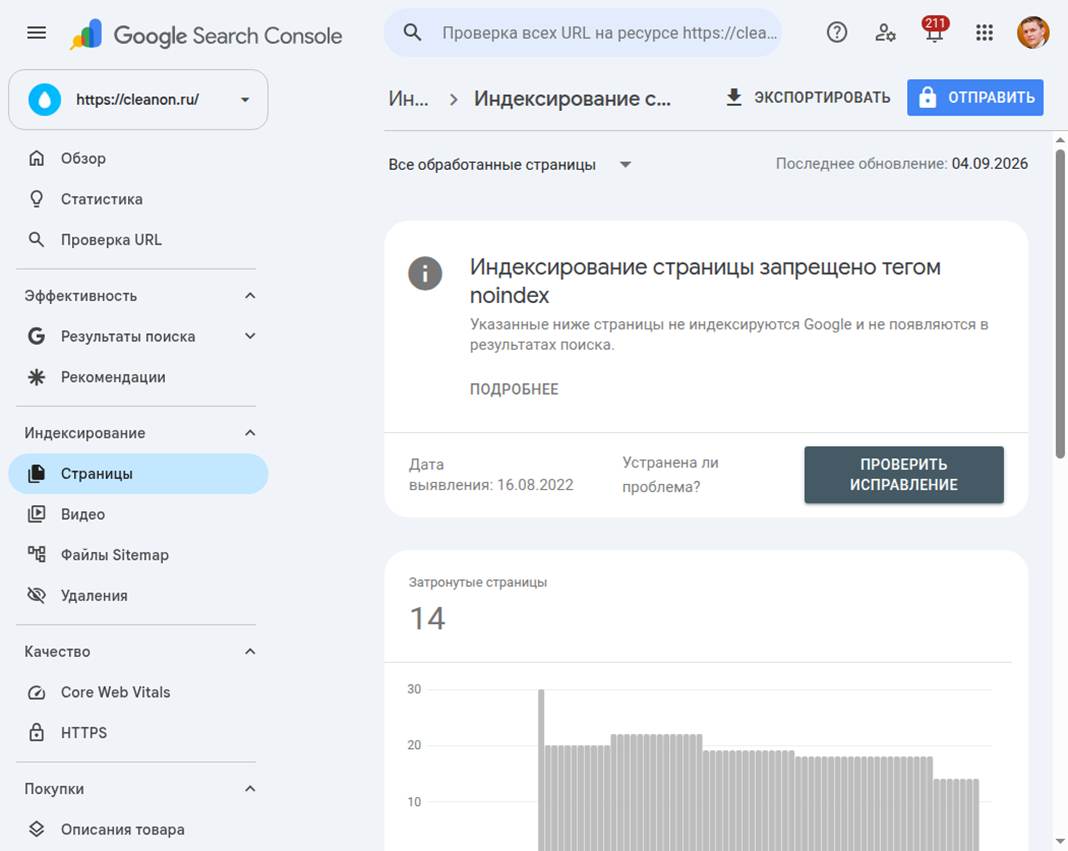
Когда это нормально
Так обычно закрывают служебные страницы, личные кабинеты, некоторые результаты поиска, страницы благодарности и другие URL, которым не место в выдаче.
Что проверить
- должна ли конкретная страница участвовать в поиске;
- где задана директива: в HTML, HTTP-заголовке, CMS или SEO-плагине;
- не закрыт ли URL одновременно в robots.txt;
- нет ли страницы с noindex в Sitemap.
Как исправить
Если страница нужна в индексе, удалите noindex, убедитесь, что сканирование разрешено, и сделайте проверку опубликованной страницы. Если исключение намеренное, удалите URL из Sitemap и оставьте статус как есть.
Страница не проиндексирована вследствие ошибки 401
Что означает статус
Сервер требует авторизацию и возвращает код 401. Googlebot не вводит логин и пароль, поэтому такой URL не будет проиндексирован.
На моих доступных ресурсах этой причины сейчас нет, поэтому отдельного скриншота с 401 здесь не будет. Подменять реальный пример картинкой из чужого аккаунта не вижу смысла.
Когда это нормально
Для закрытой части сайта, тестового стенда или кабинета пользователя такой ответ ожидаем.
Как исправить
Если страница должна быть публичной, отключите обязательную авторизацию для этого URL и проверьте его в режиме инкогнито. Если доступ закрыт намеренно, уберите адрес из Sitemap и публичных внутренних ссылок.
Страница заблокирована из-за ошибки 403
Что означает статус
Сервер понял запрос, но запретил доступ. Частая причина: WAF, CDN, модуль безопасности или антибот-фильтр блокирует Googlebot.
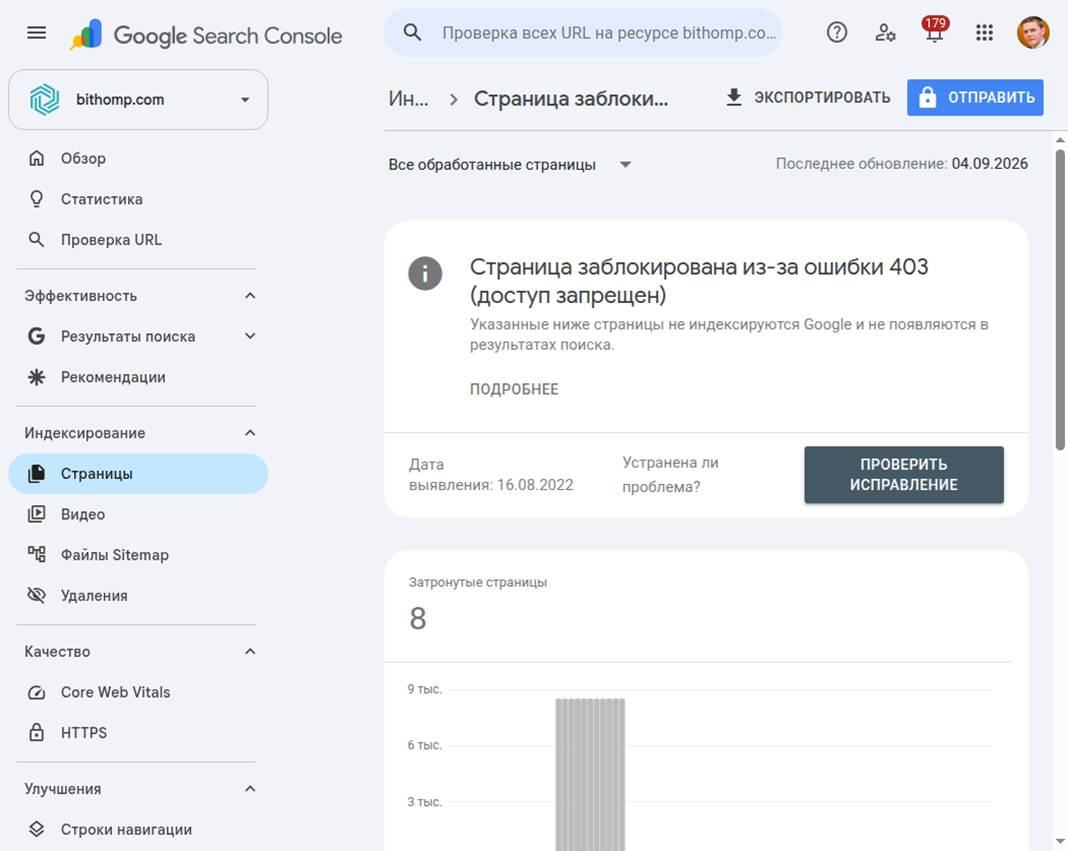
Что проверить
Обычный браузер может получать код 200, а Googlebot код 403. Поэтому нужно выполнить проверку опубликованного URL в Search Console и посмотреть серверные журналы. Не стоит разрешать доступ только по строке User-Agent: настоящий Googlebot проверяется по IP и обратному DNS или по опубликованным Google диапазонам адресов.
Как исправить
Ослабьте слишком широкое правило защиты или разрешите подтверждённого Googlebot. Если раздел действительно должен быть закрыт, удалите его URL из Sitemap и внутренних ссылок, ведущих из публичной части сайта.
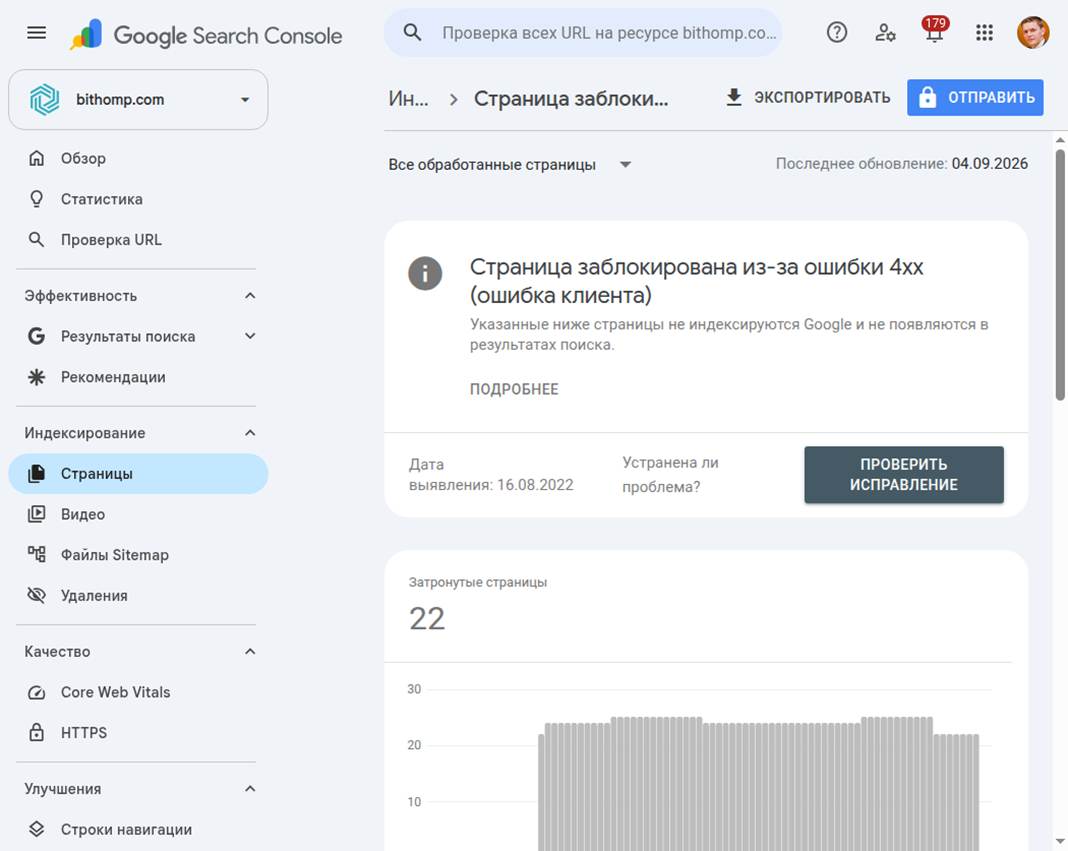
URL заблокирован из-за другой ошибки 4xx
Что означает статус
Сервер вернул другой ответ класса 4xx, который Search Console не отнёс к 401, 403 или 404. Это может быть, например, 400, 405, 429 или нестандартное поведение приложения.
Как исправить
Экспортируйте примеры и перепроверьте их обычным запросом и через проверку опубликованного URL. Для 429 нужно разбираться с ограничением частоты запросов, для 400 и 405 с маршрутизацией и обработкой метода запроса. Исправление зависит от фактического кода, поэтому общей настройки здесь нет.
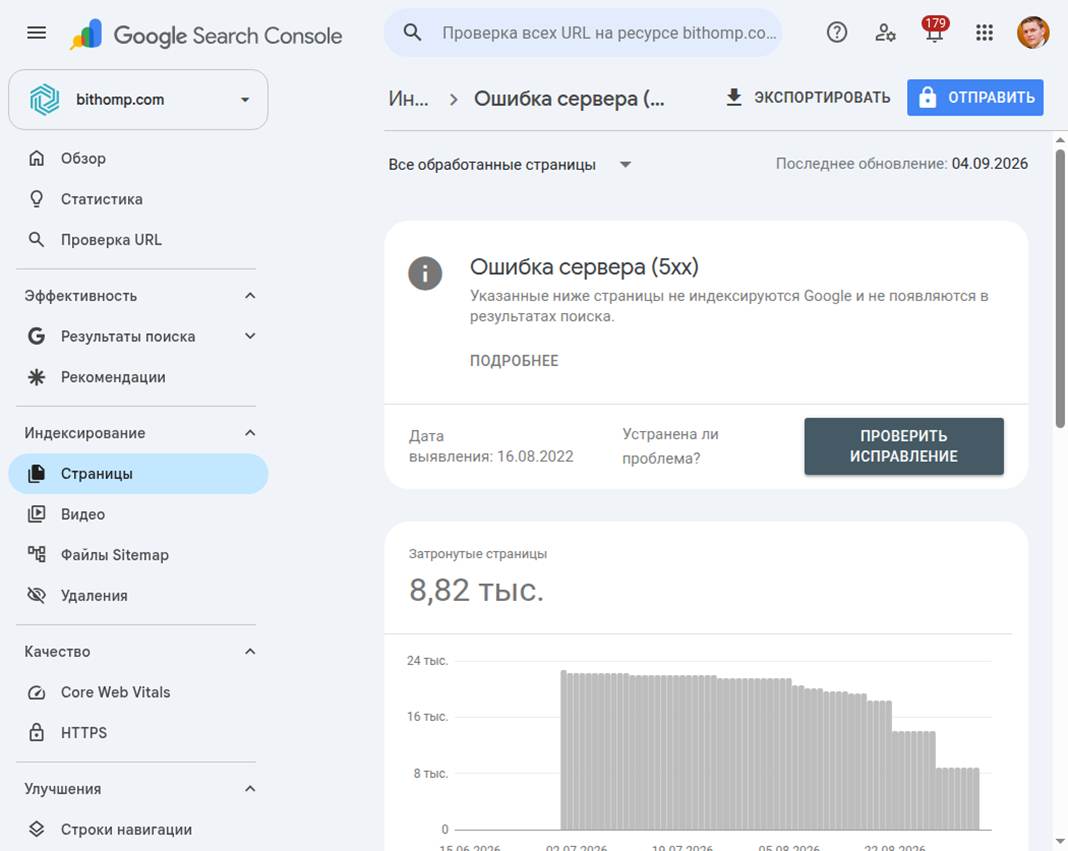
Ошибка сервера (5xx)
Что означает статус
Во время обхода сервер вернул 500, 502, 503, 504 или другой код 5xx. Google не смог получить страницу.
Что проверить
- повторяется ли ошибка сейчас;
- возникает ли она только у Googlebot;
- есть ли всплеск 5xx в логах сервера;
- хватает ли PHP-воркеров, памяти и подключений к базе;
- не блокирует ли запросы CDN или WAF;
- не оставлен ли сайт в режиме обслуживания.
Как исправить
Стабилизируйте ответ сервера и добейтесь кода 200 для страниц, которые должны индексироваться. При плановом обслуживании корректнее временно отдавать 503 с заголовком Retry-After. После исправления проверьте несколько URL на сайте и запустите проверку в Search Console.
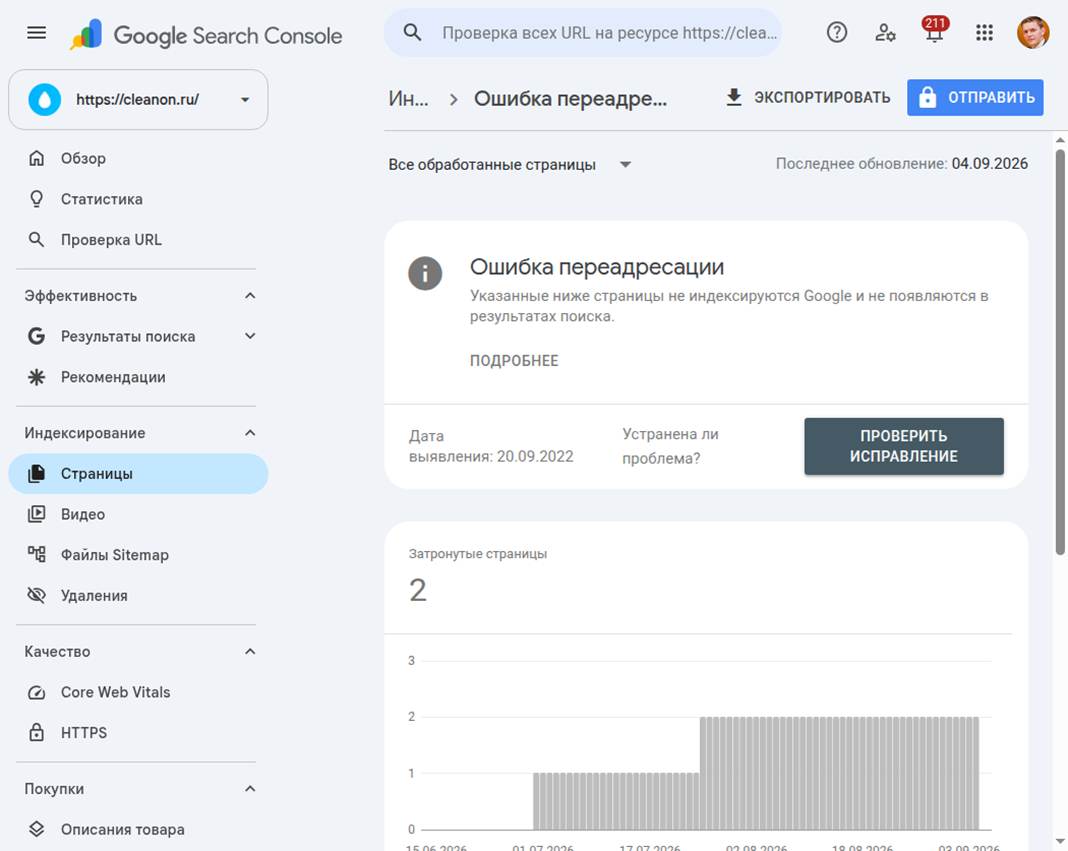
Ошибка переадресации
Что означает статус
Google не смог пройти редирект. В документации среди причин перечислены слишком длинная цепочка, цикл, слишком длинный URL, пустой или недопустимый адрес в цепочке.
Как исправить
Постройте полную цепочку переходов для каждого шаблона URL. Уберите циклы и конфликтующие правила, а старый адрес направьте сразу на конечную страницу с кодом 200. Отдельно проверьте правила HTTP/HTTPS, www/non-www, слеши, регистр и редиректы CMS: несколько независимых уровней часто начинают спорить между собой.
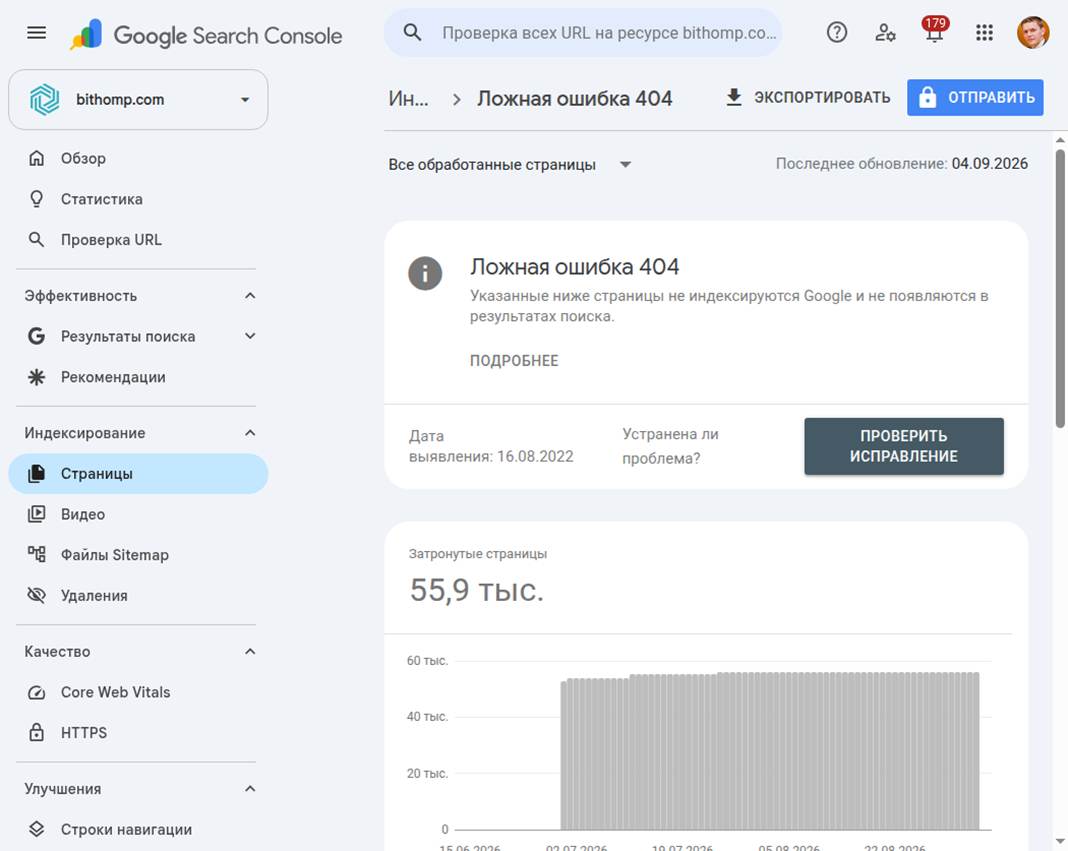
Ложная ошибка 404 (Soft 404)
Что означает статус
URL формально возвращает 200, но Google считает страницу эквивалентом ошибки 404. Обычно на ней нет основного содержимого, показано сообщение «ничего не найдено» или все удалённые URL перенаправляются на нерелевантную страницу.
Когда это встречается
- пустые результаты поиска и фильтров;
- карточки удалённых товаров без характеристик и аналогов;
- страницы с очень малым количеством полезного содержимого;
- ошибки рендеринга, при которых Google видит пустой шаблон;
- редиректы удалённых страниц на главную.
Как исправить
Если страница должна существовать, верните на неё основное содержимое и проверьте, что Google видит его в отрисованном HTML. Если страницы больше нет, отдавайте настоящий 404 или 410. Если есть близкая замена, используйте 301 именно на неё, а не на главную или случайную категорию.
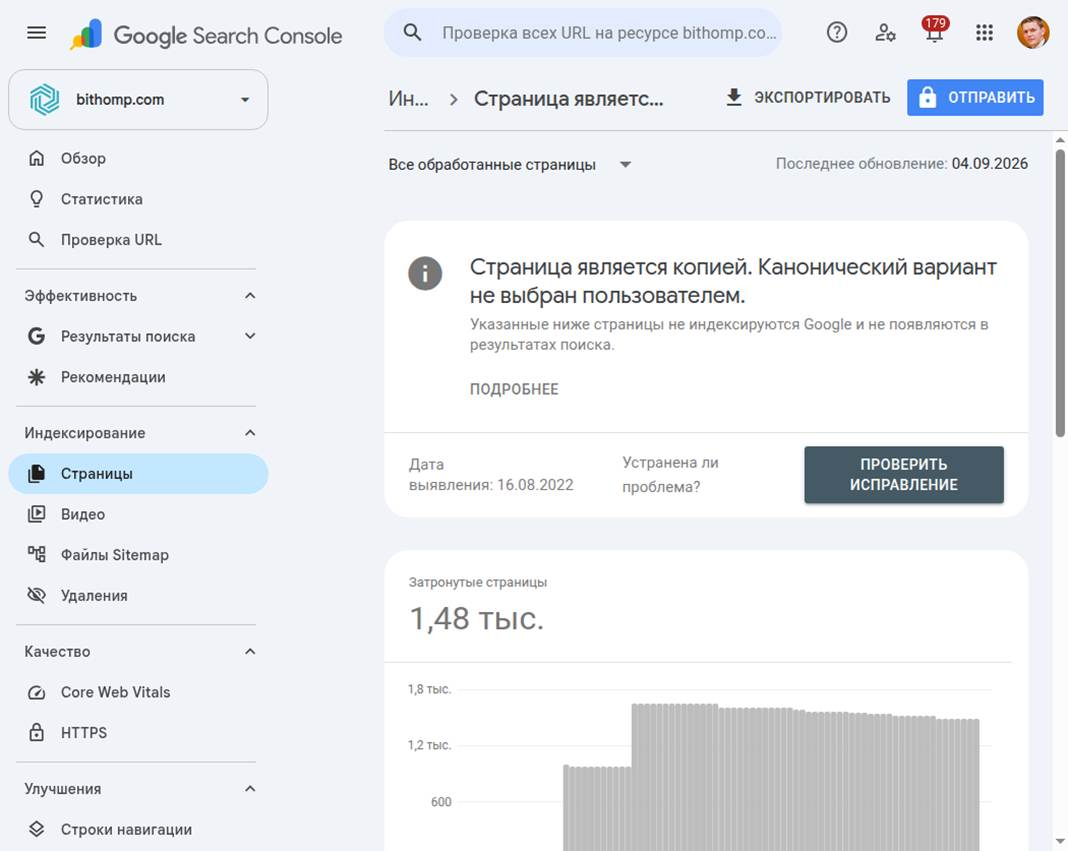
Страница является копией, канонический вариант не выбран пользователем
Что означает статус
Google считает URL дублем другой страницы. Вы не указали предпочитаемый canonical, поэтому поисковик выбрал его самостоятельно.
Когда это нормально
Google не обязан индексировать дубли. Если выбран правильный URL, непосредственной ошибки нет. Но большое количество технических копий усложняет обход и обычно говорит о том, что архитектуру можно сделать чище.
Как исправить
Проверьте выбранную Google каноническую страницу через инструмент проверки URL. Если выбор правильный, согласуйте сигналы: добавьте rel=»canonical», используйте канонический адрес во внутренних ссылках и Sitemap, а технические дубли по возможности перестаньте генерировать. Если обе страницы должны индексироваться, их содержимое и назначение должны действительно различаться.
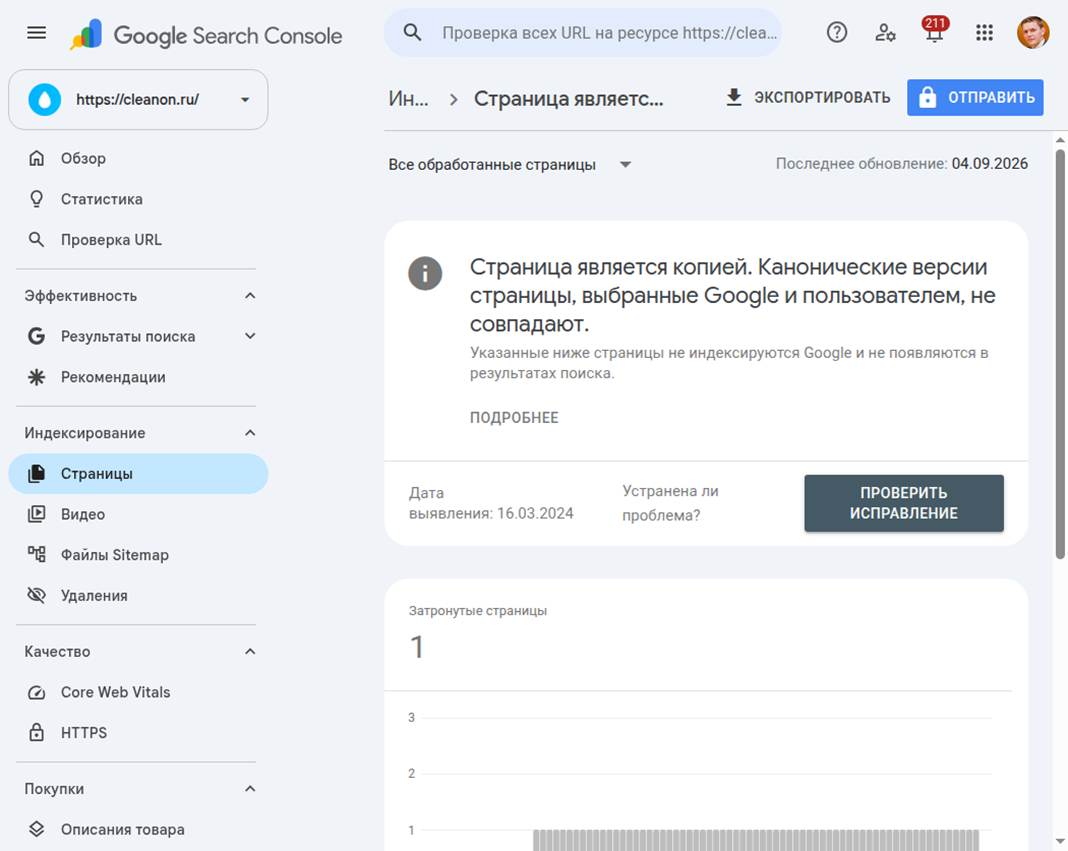
Канонические версии, выбранные Google и пользователем, не совпадают
Что означает статус
Вы указали один canonical, но Google выбрал другой URL и проиндексировал его. Это уже повод разобраться, почему сигналы расходятся.
Что проверить
- похожи ли текущая и заявленная каноническая страницы;
- не указывает ли Sitemap и внутренняя перелинковка на другой URL;
- не перенаправляется ли заявленный canonical;
- разрешена ли его индексация;
- какая версия получает больше внутренних и внешних ссылок;
- нет ли конфликтов с hreflang.
Как исправить
Сначала решите, какой адрес действительно должен быть основным. Затем приведите к нему все сигналы. Если выбор Google логичнее, иногда проще принять его и изменить свою настройку, чем пытаться закрепить менее подходящую страницу.
Страница просканирована, но пока не проиндексирована
Что означает статус
Google уже загрузил страницу, но не добавил её в индекс. Она может попасть туда позже, однако повторная отправка одного и того же URL сама по себе проблему обычно не решает.
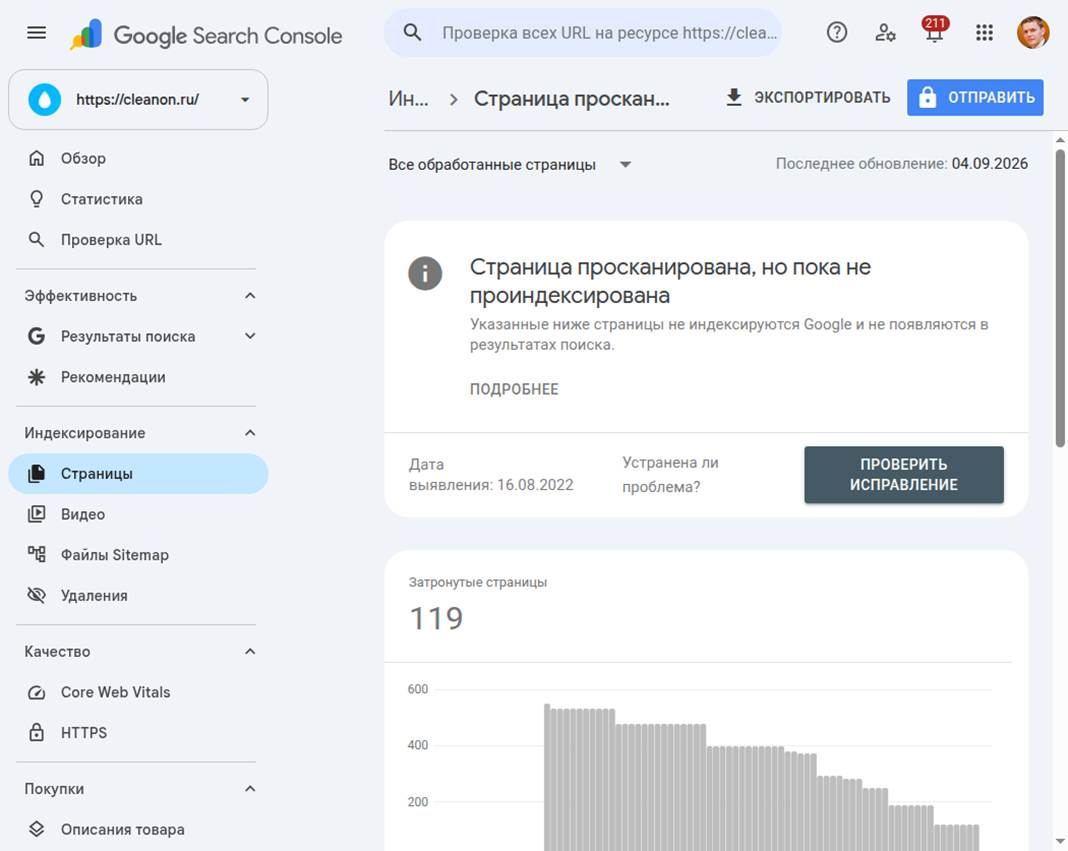
Этот статус требует ручной проверки, потому что одной универсальной причины нет. В группе могут оказаться слабые или почти одинаковые страницы, устаревшие материалы, случайные технические URL и нормальные новые страницы, которые Google ещё не обработал.
Что проверить
- есть ли на странице уникальная информация, которой нет в других документах сайта;
- соответствует ли она реальному поисковому спросу и назначению сайта;
- не является ли она почти полным дублем;
- видит ли Google основное содержимое после рендеринга;
- есть ли внутренние ссылки с тематически близких страниц;
- входит ли URL в Sitemap;
- не создано ли много однотипных страниц по шаблону.
Как исправить
Я бы не начинал с косметического увеличения текста. Сначала нужно понять, зачем эта страница существует отдельно и чем она полезнее уже проиндексированного варианта. Иногда её стоит доработать и усилить внутренними ссылками, иногда объединить с другой страницей, а иногда удалить или закрыть от индексации.
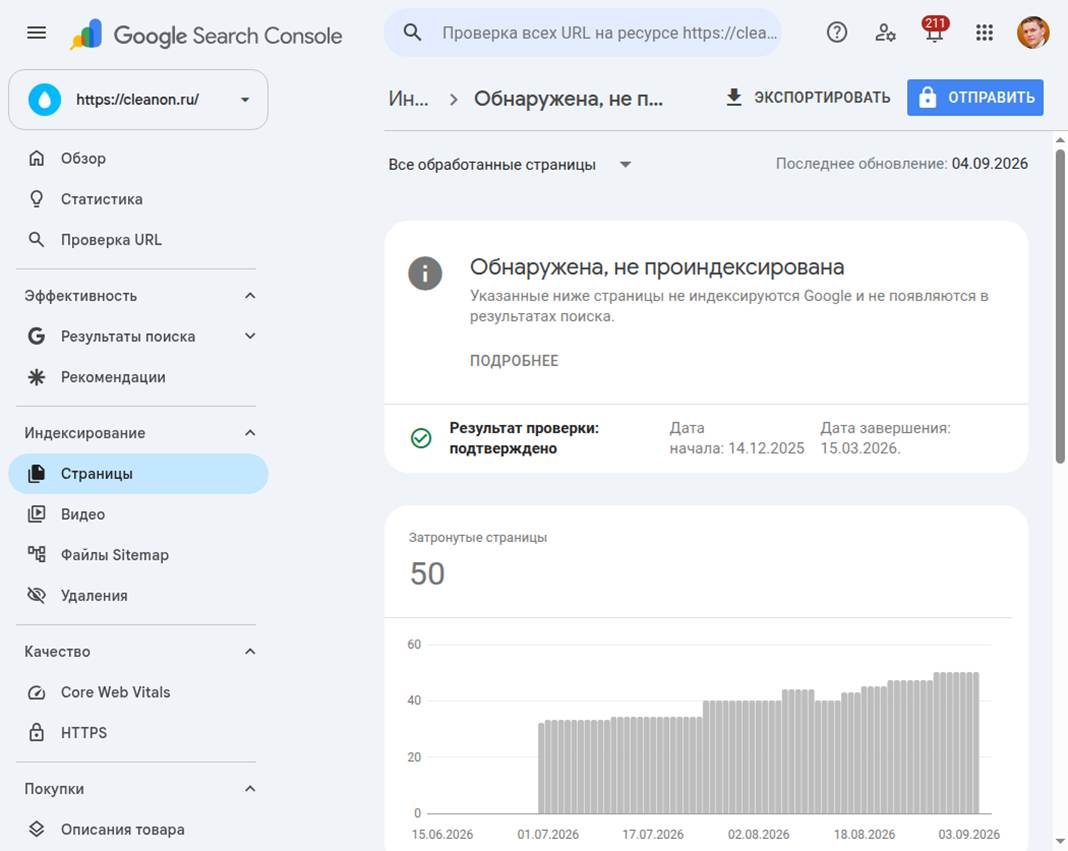
Обнаружена, не проиндексирована
Что означает статус
Google знает об URL, но ещё не просканировал его. В отчёте обычно отсутствует дата последнего сканирования. В официальной документации Google связывает этот статус в том числе с тем, что обход был отложен, чтобы не создавать чрезмерную нагрузку на сайт.
Что проверить
- как Google нашёл URL: из Sitemap, внутренних или внешних ссылок;
- насколько глубоко страница находится в структуре;
- не генерирует ли сайт слишком много параметров и технических адресов;
- стабильно ли и быстро отвечает сервер;
- есть ли ссылки на страницу с уже проиндексированных разделов;
- не появилась ли страница совсем недавно.
Как исправить
Добавьте важный URL в Sitemap и свяжите его с тематическими страницами нормальными внутренними ссылками. Уберите генерацию ненужных адресов, если они расходуют обход на технический мусор. Для небольшой группы новых страниц иногда достаточно подождать. Если статус массовый и держится долго, надо проверять структуру, скорость ответа, качество шаблонов и количество создаваемых URL.
Проиндексировано, несмотря на блокировку в robots.txt
Google может знать об адресе по ссылкам и добавить его в индекс, не сканируя содержимое. В сниппете при этом часто нет нормального описания.
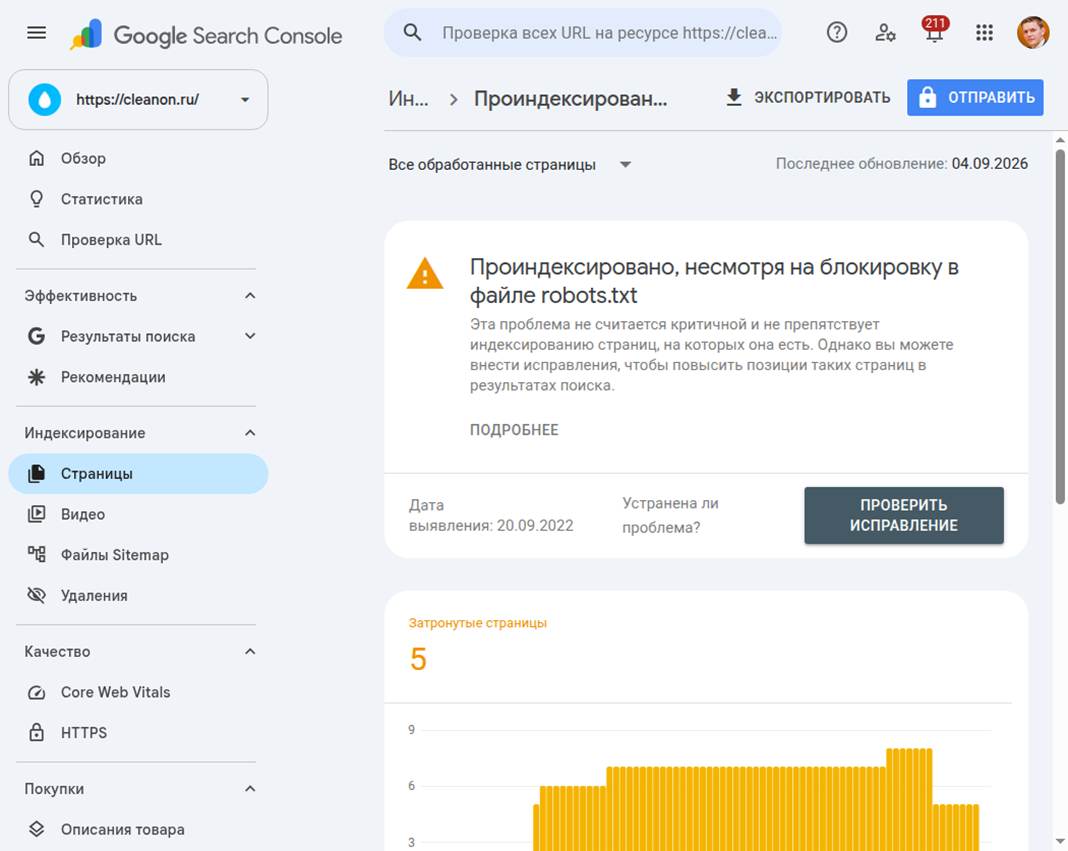
Если страницу нужно удалить из поиска, разрешите её сканирование и добавьте noindex. Если она должна индексироваться нормально, уберите запрещающее правило из robots.txt.
Страница проиндексирована без контента
URL находится в индексе, но Google не смог обработать его содержимое. Возможны проблемы с форматом, рендерингом, ответом сервера или тем, что содержимое отличается для пользователей и Googlebot.
На доступных ресурсах такого предупреждения сейчас тоже нет. Оставляю его в списке, потому что Google описывает этот статус в справке, но придумывать пример ради комплекта не буду.
Проверьте опубликованную страницу и отрисованный HTML в Search Console, доступность ресурсов, ответ сервера и логи. Для обычной HTML-страницы такой статус нельзя считать нормальным.
Почему не надо сразу нажимать «Проверить исправление»
Эта кнопка не исправляет сайт и не заставляет Google мгновенно переиндексировать все URL. Она запускает проверку группы страниц с одной конкретной проблемой. Если Google быстро найдёт хотя бы один URL, на котором причина сохранилась, проверка завершится ошибкой.
Сначала исправьте весь шаблон, перепроверьте несколько разных страниц и только после этого запускайте проверку. По данным справки Google, процесс обычно занимает около двух недель, но иногда дольше. Даже без нажатия кнопки Google со временем увидит изменения при обычном сканировании.
Короткий алгоритм работы с непроиндексированными страницами
- Определите, должна ли конкретная страница быть в поиске.
- Проверьте код ответа, доступность для Googlebot, robots.txt, noindex и canonical.
- Сравните URL с Sitemap и внутренними ссылками.
- Для дублей посмотрите canonical, выбранный Google.
- Для статусов «Просканирована» и «Обнаружена» оцените назначение, уникальность, перелинковку и количество однотипных URL.
- Исправьте причину на всём шаблоне.
- Проверьте опубликованные страницы в Search Console.
- Запустите «Проверить исправление», если это действительно ошибка, а не нормальное исключение.
Главная мысль здесь довольно простая: отчёт об индексировании нужно читать по URL, а не по цвету и общей цифре. Иногда тысяча исключённых страниц не требует никаких действий. А иногда один URL услуги с неправильным noindex стоит проверить в первую очередь.


