Проверить, может ли нейросеть прочитать сайт, сложнее, чем посмотреть одну строку в robots.txt. У разных систем разные боты и задачи: одни собирают данные для обучения, другие ищут страницы для ответов пользователям. Сайт может разрешать обход в robots.txt, но отдавать боту 403 из-за настроек защиты. Или отвечать кодом 200, а весь основной текст подгружать только через JavaScript.
Собрал восемь бесплатных инструментов, которые помогают проверить эти вещи без регистрации. Для этой подборки я открыл их публичные формы и запустил проверку тестового домена. Скриншоты главных страниц сняты 27 октября 2026 года. Интерфейсы и бесплатные лимиты со временем могут меняться.
Что именно нужно проверять
Условно есть четыре уровня. Первый — разрешает ли robots.txt обход нужному user-agent и конкретному пути. Второй — что сервер реально отдаёт при запросе: 200, редирект, 403, 429 или пустую страницу. Третий — есть ли текст и ссылки в исходном HTML без выполнения скриптов. Четвёртый — доступны ли важные страницы по внутренним ссылкам и нет ли конфликтов с sitemap, noindex или canonical.
Сервисы из подборки закрывают разные части этой цепочки. Результат «Allowed» обычно означает только отсутствие запрета в robots.txt. Это не подтверждение, что конкретная нейросеть уже обошла страницу, использовала её в ответе или будет ссылаться на сайт.
Есть ещё путаница с именами ботов. У OpenAI OAI-SearchBot связан с поиском в ChatGPT, а GPTBot — с обходом для обучения моделей. ChatGPT-User используется при действиях пользователя и не является обычным поисковым краулером. У Google AI Overviews в Поиске доступом управляет Googlebot; Google-Extended — отдельный управляющий токен для других сценариев, а не «бот AI Overviews». Эти различия лучше держать в голове, когда сервис рисует один общий зелёный статус «ChatGPT» или «Gemini».
1. CrawlerCheck — проверить доступ к конкретной странице
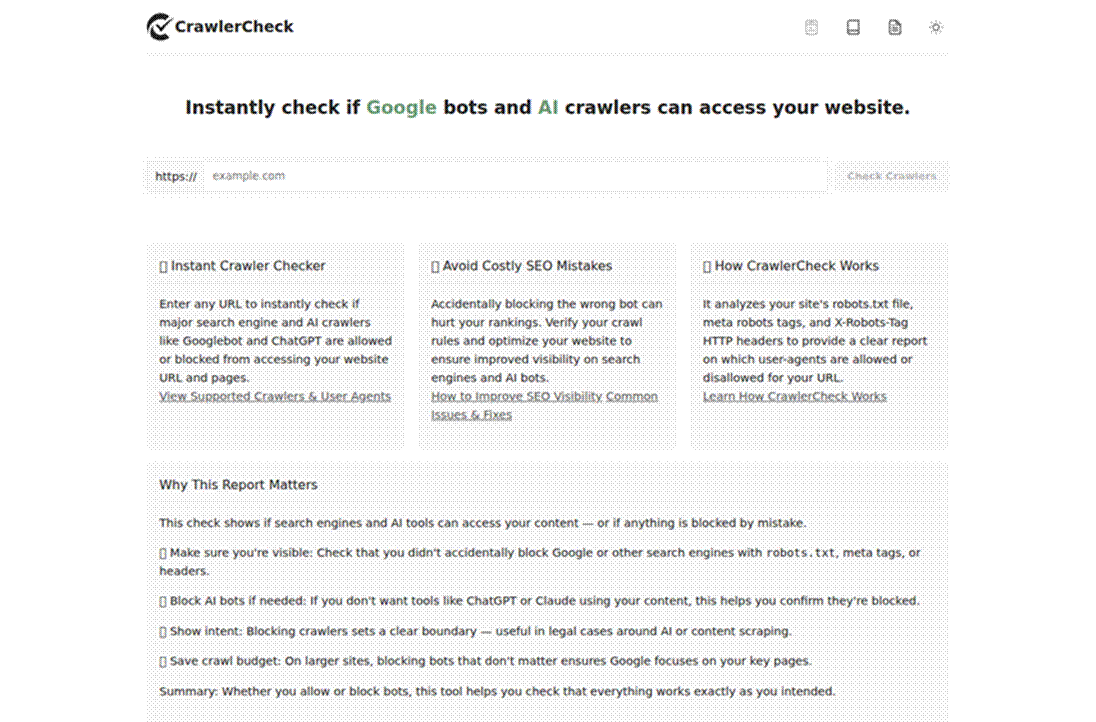
Главная страница CrawlerCheck: поле для URL и проверка доступа краулеров.
Вставляете адрес страницы, а сервис показывает доступ по категориям: поисковые боты, AI-боты, социальные краулеры и другие. В детальном отчёте учитываются robots.txt, meta robots и HTTP-заголовок X-Robots-Tag. На тестовой странице результат открылся без аккаунта.
Этот вариант удобен, когда вопрос звучит конкретно: «Не закрыта ли вот эта статья для OAI-SearchBot или Googlebot?» Проверять только главную страницу сайта недостаточно — правила могут отличаться для каталога, блога и отдельных URL.
Ограничение: отчёт моделирует правила и делает собственные запросы. Он не докажет, что настоящий бот с его IP-адреса пройдёт защиту CDN или WAF. Если подозреваете блокировку на сервере, смотрите логи.
2. Writesonic — увидеть страницу без JavaScript
https://writesonic.com/free-tools/ai-crawl-checker
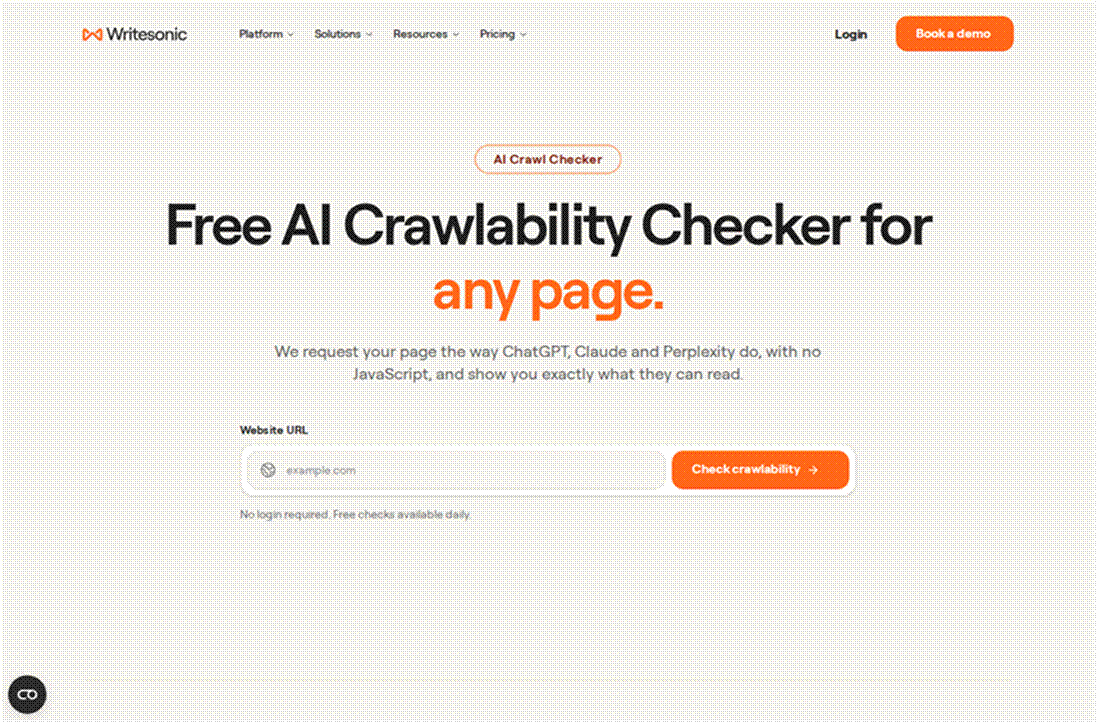
Главная страница бесплатного AI Crawl Checker от Writesonic.
Здесь акцент на содержимом, которое приходит в первом HTML-ответе. В отчёте есть текст и ссылки исходной страницы, сигналы рендеринга, доступ отдельных ботов и robots.txt. Проверка запускается без входа; сервис указывает дневной лимит бесплатных запусков.
Полезно для сайтов на JavaScript-фреймворках: если заголовки, основной текст и ссылки появляются только после выполнения скриптов, отдельный краулер может получить почти пустой HTML. Но к оценке сервиса я бы относился как к подсказке, а не к диагнозу. На лаконичной статической example.com он назвал основной контент зависимым от JavaScript. Такой вывод стоит перепроверять через «Просмотр кода страницы» и собственный HTTP-запрос.
3. Orchly — быстрый отчёт по одной странице
https://orchly.ai/free-tools/ai-crawlability-checker
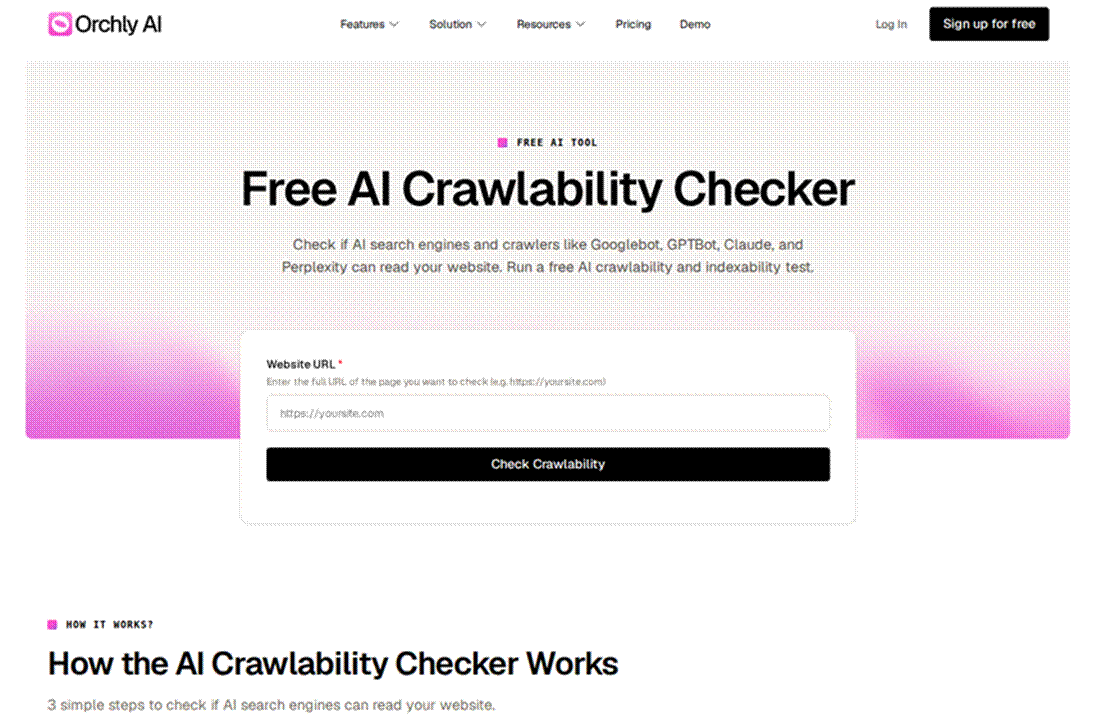
Главная страница Orchly: форма проверки конкретного URL.
После ввода полного URL Orchly показывает доступ Googlebot, GPTBot, ClaudeBot, PerplexityBot и Bingbot. Дополнительно выводит статус robots.txt, объём текста, признаки семантической разметки, метатеги, структурированные данные и HTTP-статус. В моей проверке отчёт появился сразу, без регистрации.
Удобен для первого осмотра страницы. Но итоговый балл и рекомендации вроде «добавьте JSON-LD» не стоит автоматически превращать в задачу. Отсутствие разметки само по себе не означает, что страница недоступна краулеру.
4. AI Crawler Check — много user-agent в одном отчёте
Главная страница AI Crawler Check с формой проверки домена.
Сервис перебирает большой каталог ботов и раскладывает их по группам. Отдельно проверяет robots.txt, sitemap и llms.txt, показывает правила для конкретных user-agent и предлагает выгрузить отчёт. Для example.com подробный результат открылся без почты и аккаунта.
Полезен, если на сайте длинный robots.txt и нужно быстро увидеть, какие группы попали под общий Disallow. Но в его балльной оценке есть очки за llms.txt. Этот файл не является обязательным условием индексации или появления в ответах ИИ. Поэтому зелёные и красные цифры здесь не заменяют проверку конкретной проблемы.
5. CompetLab — доступ именно поисковых AI-систем
https://competlab.com/tools/ai-crawler-checker
Главная страница бесплатной проверки AI-краулеров CompetLab.
Сервис группирует результат по системам: ChatGPT, Claude, Perplexity, Copilot, AI Overviews и Gemini Apps. Показывает, какие правила robots.txt повлияли на вывод, и поясняет, что разрешение на обход ещё не означает цитирование. На тестовом домене результат был виден без входа.
Мне нравится, что здесь не смешаны все боты в один статус. Важное ограничение сервис тоже проговаривает: правила robots.txt — только один слой. Meta robots, X-Robots-Tag и возможность прочитать саму страницу проверяются отдельно.
6. Resolve247 — robots.txt и пробное чтение страницы
https://resolve247.ai/tools/robots-txt-checker

Главная страница Resolve247: проверка robots.txt и пробное чтение страницы.
Можно вставить домен, адрес страницы или сам robots.txt. Сервис разделяет разрешённых и запрещённых краулеров, показывает исходные правила. После основной проверки предлагает отдельно попробовать прочитать страницу как краулер. Результат для тестового домена появился без регистрации.
Этот второй шаг полезен: robots.txt может разрешать обход, а страница всё равно окажется пустой или недоступной. Но пробный запрос инструмента не равен запросу любого реального бота: настройки защиты сайта зависят не только от User-Agent, но и от IP, частоты запросов и других условий.
7. Superflow — проверить, не мешает ли защита сайта
https://usesuperflow.ai/tools/robots-txt-ai-checker
Главная страница тестера robots.txt для AI-краулеров от Superflow.
Superflow проверяет правила для поисковых и обучающих ботов и сравнивает ответ страницы при обычном запросе с запросом под User-Agent краулера. На example.com бесплатный отчёт появился без логина и email. В нём отдельно отмечены robots.txt, sitemap, llms.txt и совпадение ответа сервера.
Открывать его имеет смысл, если файл robots.txt выглядит корректно, но есть подозрение на блокировку в CDN или WAF. И здесь нельзя принимать один успешный тест за стопроцентное доказательство: реальный бот может приходить с другого адреса и получить иной ответ. Замечание об отсутствии llms.txt — не критическая SEO-ошибка.
8. openllmrank — проверить не только запрет, но и путь обхода
Главная страница openllmrank: экспресс-проверка обхода сайта.
Этот инструмент ближе к небольшому краулеру. Он начинает с главной, проверяет robots.txt и sitemap, проходит по внутренним ссылкам и ищет проблемы с доступом: битые переходы, страницы из sitemap без внутренних ссылок, конфликты с noindex. Бесплатная проверка для example.com завершилась без аккаунта, хотя отчёт формировался не мгновенно.
Он пригодится, когда боты не заблокированы, но важные разделы плохо связаны между собой. Однако экспресс-обход не заменяет полноценного технического аудита большого сайта. Платный мониторинг и отдельный отчёт по упоминаниям сервиса в этой подборке не рассматриваю.
Что делать после автоматической проверки
Я бы начинал с одного важного URL, а не с абстрактной оценки всего домена. Прогоните его хотя бы через два инструмента с разным методом: например, CrawlerCheck для правил доступа и Writesonic для исходного HTML. Если результаты расходятся, это повод разбираться, а не выбирать тот, где балл выше.
- Проверьте, какой именно бот нужен. Для появления в поиске ChatGPT важнее OAI-SearchBot, чем один только GPTBot. Для AI Overviews в Google важен обычный Googlebot.
- Откройте robots.txt именно нужного хоста и проверьте правило для пути страницы. Поддомены и основной домен могут иметь разные файлы.
- Проверьте HTTP-код, редиректы, meta robots и X-Robots-Tag. Код 200 на главной ничего не говорит о доступности отдельной статьи.
- Посмотрите исходный HTML: есть ли в нём основной текст, заголовки и ссылки до выполнения JavaScript.
- Если сервисы показывают «разрешено», а обхода нет, проверьте логи сервера и правила CDN/WAF. Для Google отдельно используйте проверку URL в Search Console.
И не смешивайте доступность с видимостью. Разрешить обход — необходимое техническое условие для многих сценариев, но оно не делает сайт автоматически источником ответов. Здесь по-прежнему работают нормальная структура, содержание страниц, внутренние ссылки и известность бренда. Отдельной магической настройки «включить GEO» у сайта нет.


